
"超大模型实测:M5 Max显存24GB性能对比RTX 5090,速度快7倍"
2026-08-21 14:05:15
8月21日消息,依据博主Alex Ziskind的测试数据,英伟达RTX 5090移动版在与苹果M5 Max的本地AI性能对比中,中小模型场景的算力优势最高可达133%——但由于显存容量的限制,在超大模型和超长上下文的测试条件下,被M5 Max实现了反超。
此次测试使用了最新的雷蛇灵刃18笔记本,其搭载的RTX 5090拥有24GB显存,在运行Gemma 4 12B、Qwen3.5 27B等主流规模的本地大模型时,RTX 5090无论是提示词处理速度还是文本生成速度,都大幅领先M5 Max。
实测数据显示,在12B-35B规模模型下,Gemma 4 12B模型中RTX 5090跑出4110 tokens/sec,相较M5 Max的1762 tokens/sec领先133%。

Qwen3.5 27B同样拉开109%的差距,即便到35B级别的Qwen3.6 35B A3B,RTX 5090依旧保有32%的提示词处理优势。
不过一旦进入超大模型、超长上下文这类高负载场景,测试结果就出现反转。
在Qwen3 4B模型的26万超长上下文测试中,RTX 5090的24GB显存瞬间告急,生成速度骤降至25.28 Token/秒。
反观拥有128GB统一内存的M5 Max,此时依然能稳定输出181.40 Token/秒,领先优势接近7倍。
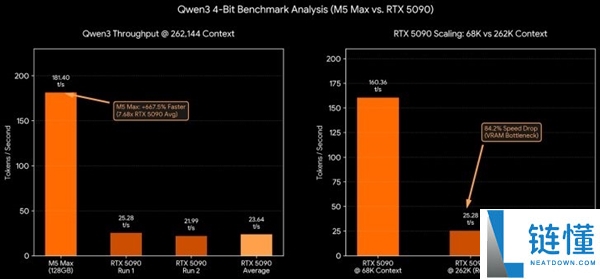
对比RTX 5090自身的两组测试更能直观看到显存带来的性能差距,在68K上下文条件下,显卡还可以跑出160.36 tokens/sec。
一旦上下文扩大到262144,受24GB显存上限约束,性能直接暴跌84.2%,吞吐量仅剩21-25 tokens/sec。
对于普通发烧友而言,如果你的AI应用侧重于高频短文本生成,RTX 5090依然是不二之选,但若涉及超长文档分析,显存容量的权重可能要排在算力之前。
 相关阅读
-
OKEX交易所支持的主要币种介绍链百科 2026-08-21 14:03:24
-
创见发布全系列DDR5-7200工业内存模组,支持-20℃至85℃宽温工作范围链资讯 2026-08-21 14:00:00
-
比亚迪旗舰纯电轿车大汉预售,续航1008km起价24.99万元链资讯 2026-08-21 13:53:40
-
什么是GOPAY钱包及其功能详解链百科 2026-08-21 13:48:23

-
山西警方破获新型网络水军案:揭露洗稿、AI转写批量制造小米负面新闻链资讯 2026-08-21 13:47:56
-
美国芯片替代者!井芯微发布国产交换与桥接芯片:600Gbps带宽与100ns延迟链资讯 2026-08-21 13:41:29
-
女子在亚航飞往上海航班上排泄,熟睡乘客被臭醒,亲历者称厕所距离仅5米链资讯 2026-08-21 13:35:49
-
第三方钱包下载推荐软件指南【2024最新版】链百科 2026-08-21 13:33:51

-
全新深蓝G318上市:19.68万起,20万级独家配备华为双智方盒子链资讯 2026-08-21 13:29:45
-
《GTA6》重磅泄露!黑客掌握可运行完整版,R星紧急应对危机链资讯 2026-08-21 13:24:31
 热门资讯