
中科曙光ParaCache技术:提升GPU数据处理效率,Token并发提升16倍!
2026-10-30 12:14:48
10月30日消息,在10月29日于郑州举办的2026数据存储产业大会上,中科曙光展示了以<strong>AI数据工厂</strong>为核心的最新探索,推动存储从被动数据保存转向主动参与AI生产全流程,解决大模型推理中Token生成效率低下的核心痛点。
随着AI从生成迈入执行阶段,智能体长上下文和多轮交互需要持续访问与更新数据。数据供给不及时、计算结果难以复用,不仅增加响应延迟,也造成算力资源浪费。
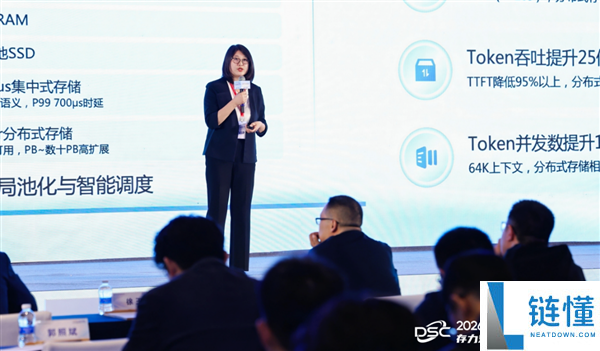
中科曙光分布式存储产品部总经理石静指出,存储的核心价值是持续向Agent提供可检索、可更新、可治理的记忆与上下文。
要让存储真正加速Token生成,先要解决数据分散与孤岛问题。中科曙光依托ParaStor分布式存储与FlashNexus集中式存储,通过统一命名空间和多协议访问实现海量异构数据的统一管理,并根据数据热度跨介质、跨平台调度,减少重复搬运。
在此之上,“存-算-传-用”全栈协同进一步压缩I/O路径。通过XDS数据直通、BurstBuffer本地缓存与scaleFabric高速网络协同优化,数据读取与模型计算得以并行开展,让GPU尽量不再空等数据。
推理环节的关键突破在于KV Cache的管理。ParaCache统一管理多级KV Cache并实现跨节点共享,减少重复计算。在64K上下文测试中,相较GPU纯计算方式,采用分布式存储的方案Token并发数提升16倍,首Token时延降低95%以上。
目前,曙光AI数据工厂方案已在多个场景落地验证。在国家超算互联网核心节点曙光8000系统中,数百PB级存储构建了统一数据底座。
在智元机器人数采工厂,百PB级对象存储与数十PB级全闪文件存储协同,支撑上千小时训练不间断;在自动驾驶领域,全闪与混闪统一资源池提供100PB以上可用空间。
从数据容器到AI数据工厂,存储的角色正在被重新定义。当Token生成的效率直接决定AI应用的成本与体验,让数据按需流动、让计算结果持续复用,正在成为算力之外的另一条提速路径。
 相关阅读
-
大零币隐私交易设置方法详解链知识 2026-10-30 12:11:22
-
龙芯3A6000成功实现全局构建,获国际开源生态支持,继x86/ARM/RISC-V后迎来龙架构新机遇链资讯 2026-10-30 12:08:45
-
Gemini是什么?2026年免费使用指南、价格及注册教程链百科 2026-10-30 12:06:14
-
福特CEO挑战比亚迪:我们的电机效率高出30%,可实现更小电池使用链资讯 2026-10-30 12:02:18
-
布加迪CEO价值2200万Chiron被盗:随手丢钥匙的教训链资讯 2026-10-30 11:57:05
-
PSBT详解:如何进行部分签署比特币交易及离线签署教学链百科 2026-10-30 11:56:10
-
Agix是什么币?Agix币的投资价值分析与前景展望链知识 2026-10-30 11:51:13
-
奔驰AMG GLC 53上市:3.0T直列六缸动力,4.2秒破百,仅售59.9万元链资讯 2026-10-30 11:50:55
-
Netflix推出FTX交易所改编剧集:直击牢里的SBF取经故事链百科 2026-10-30 11:46:45
-
比亚迪方程豹钛7热销!连续12个月夺得方盒子销量冠军,击败竞争对手链资讯 2026-10-30 11:44:24
 热门资讯